Türkçe klinik dile uyarlanan
yapay zekâ modelimiz MINA
MINA, Türk klinik pratiği için tasarlayıp geliştirdiğimiz klinik yapay zekâ modelidir. Açık ağırlıklı bir büyük dil modelini sürekli ön eğitimle (CPT) Türkçeye ve 14 branşın klinik diline uyarladık; LoRA adaptörleriyle de branş, kurum ve görev bazında uzmanlık kazandırdık. Klinik bilgi grafı (GraphRAG) üzerinde çalışan ajanik orkestrasyon ise modeli güncel klinik literatüre bağlar.
MINA v3.7'nin ICD-10 kodlama, SUT uygunluğu, suistimal tespiti, epikriz ve klinik karar görevlerindeki değerlendirme sonuçlarını ve önceki sürümlere göre ilerlemesini ayrı bir sayfada yayımladık.
Değerlendirme sonuçlarını inceleyin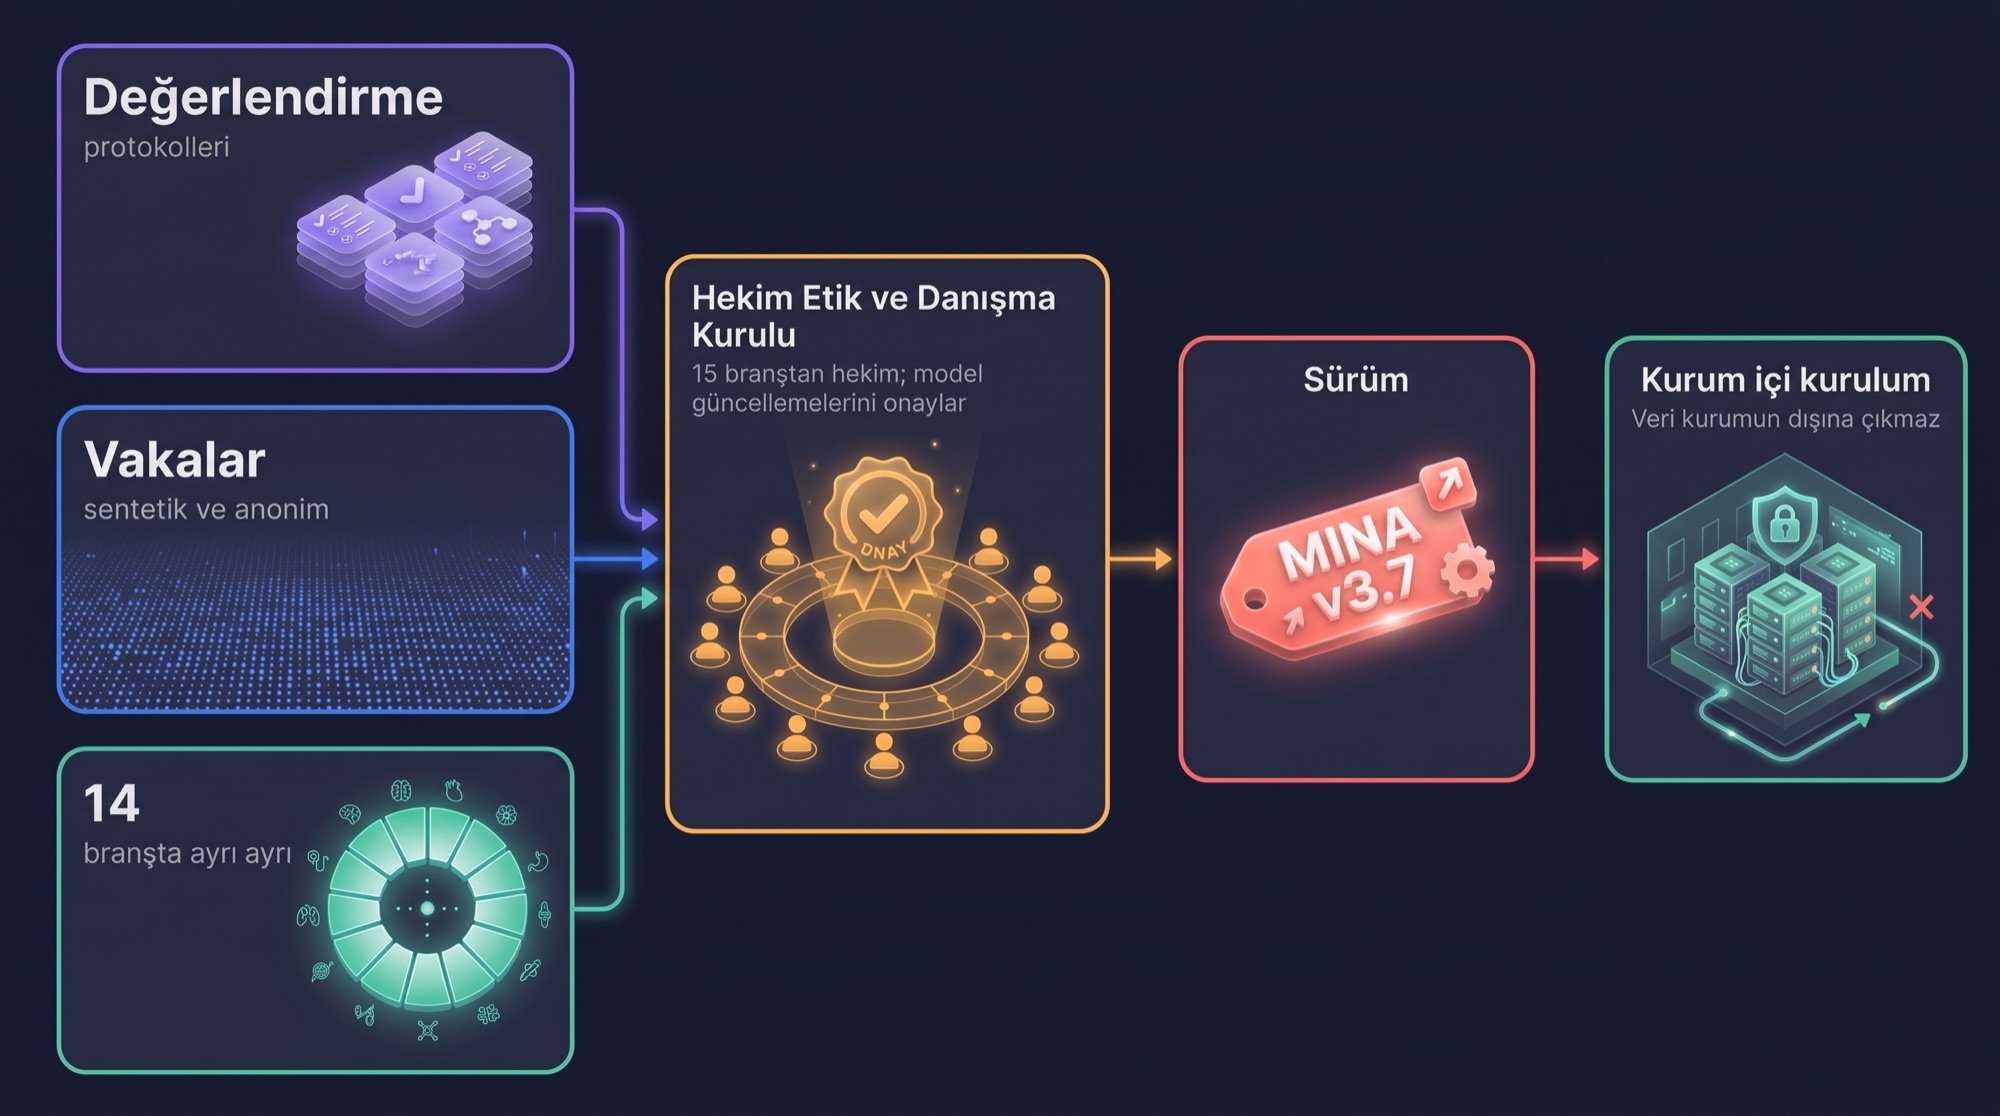
Klinik pratik
her ülkede farklıdır
Türkiye'de bir hekimin karşılaştığı hasta, başvurduğu kılavuz, yazdığı epikriz ve tabi olduğu SGK ve SUT kuralları bu ülkeye özgüdür. MINA'yı bu koşullar için geliştirdik.
Genel amaçlı yabancı bir modeli Türkçeye çevirmenin yetmediğini biliyoruz. Bu yüzden MINA'yı açık ağırlıklı bir temel modelin üzerine, aşağıda anlatılan üç katmanla kurduk.
MINA nasıl geliştirildi
Genel amaçlı bir dil modeli Türkçe metin üretebilir. Ancak bir epikrizi Türk klinik pratiğinin diliyle okumak, uygun ICD-10 kodunu önermek, bir istemin SUT'a (SGK Sağlık Uygulama Tebliği) uygun olup olmadığını değerlendirmek ve her yanıtı dayandığı kaynağa bağlamak başka bir hazırlık ister. MINA'yı beş yıldır bu hazırlığı yaparak geliştiriyoruz.
Aşağıda, açık ağırlıklı bir temel modelin Türk klinik pratiğinde çalışan bir karar destek modeline nasıl dönüştüğünü yedi aşamada anlatıyoruz: verinin hazırlanması, Türkçe klinik metnin tokenlara ayrılması, sürekli ön eğitim, LoRA uzmanlık adaptörleri, GraphRAG ile bilgi erişimi, ajanik orkestrasyon ve klinik doğrulama. MINA'nın üç katmanı, yani temel model, uyarlama ve orkestrasyon, bu aşamalarda kurulur.
MINA'nın başvurduğu kaynaklar arasında PubMed, The Lancet, JAMA, BMJ, UK Biobank, MIMIC-IV ve ClinicalTrials yer alır.

1. Veri: kaynakların toplanması ve hazırlanması
MINA, Türk klinik pratiğinin diliyle yazılmış kaynaklardan öğrendi; kurumların hasta verisi MINA'nın ortak modelinin eğitiminde kullanılmadı.
Bir modelin neyi ne kadar iyi yapacağını büyük ölçüde beslendiği veri belirler. MINA'nın Türk klinik dilini öğrenmesi için Türk tıbbi terminolojisini, klinik kılavuzları ve anonim klinik kayıtları bir araya getirdik. MINA'nın bilgi tabanı ise 14 branşta 30M+ kaynağa dayanır; bunların başında uluslararası tıbbi literatür, klinik araştırma kayıtları, açık erişimli sağlık veri setleri, kanıta dayalı klinik kılavuzlar, SUT ve SGK mevzuatı ile uluslararası tıbbi kodlama standartları gelir.
Kurumların hasta verisi bu kaynaklara eklenmez. Kuruma özel LoRA adaptörleri kurumun kendi ortamında, kurumun kendi verisiyle eğitilir ve kurumun içinde kalır; kurum verisi MINA'nın ortak modelinin eğitiminde kullanılmaz. Kaynakların ayrıntılı listesini ve hangi koşullarla kullanıldıklarını sayfanın ilerleyen bölümünde, veri kaynakları başlığı altında veriyoruz.
MINA bir kuruma kurulduğunda, okuyacağı veri de katmanlı bir hatla hazırlanır. Kurumun kendi ortamında çalışan ve medallion mimarisi olarak bilinen bu üç katmanlı yapıda ham veri önce Bronze katmanına alınır. Silver katmanında temizlenir, ortak bir biçime getirilir (normalize edilir) ve kişisel veriler KVKK gerekliliklerine göre maskelenir. Gold katmanında ise klinik analitik, fatura uyum kontrolü ve hasta dijital ikizi için yapılandırılmış veri üretilir. Veri kurumun dışına çıkmaz; veri sorumlusu kurumdur. Hastane açısından bunun anlamı, MINA'nın kurumun verisiyle, bu veri kurumun ortamından hiç çıkmadan çalışabilmesidir.

2. Tokenizasyon: Türkçe klinik metnin tokenlara ayrılması
MINA, Türkçe klinik metni eklerin ve Latince terimlerin arasında kaybolmadan okur.
Dil modelleri metni harf harf ya da kelime kelime okumaz; token adı verilen parçalarla çalışır. Bir token tam bir kelime, bir kelimenin kökü ya da tek bir ek olabilir. Tokenizer adı verilen bileşen her cümleyi bu parçalara ayırır ve her parçaya bir numara, yani token ID'si verir. Model bundan sonra metni bu numaraların dizisi olarak işler.
Türkçe eklemeli bir dildir: tek bir kelime, kökünün yanında birden fazla ek taşıyabilir. “Şüphesiyle” kelimesinde bir kök ve iki ek vardır. Klinik terimler ise çoğunlukla Latince ya da Yunanca kökenlidir ve genel metinlerde seyrek geçer. Bu yüzden bir klinik terim birden fazla tokena bölünebilir; görseldeki örnekte “enfarktüsü” kelimesi “enfarkt” ve “üsü” olarak iki parçaya ayrılıyor.
Bu parçaların bir arada ne anlattığını model, bir sonraki aşamada Türkçe klinik metinler üzerinde eğitilerek öğrenir. Hekim için bunun karşılığı, epikrizde yazdığı cümlenin eklerin arasında kaybolmadan, klinik anlamıyla okunmasıdır.

3. Sürekli ön eğitim (CPT): modelin Türk klinik dilini öğrenmesi
MINA, Türk klinik dilini ana dili gibi öğrendi.
MINA'yı sıfırdan eğitmedik. Genel dili zaten öğrenmiş, açık ağırlıklı bir temel modelle başladık. Açık ağırlıklı model, öğrendiklerini tutan sayısal parametreleri, yani ağırlıkları erişime açık olan modeldir; bu sayede eğitimine kaldığı yerden devam edilebilir. Biz de bu modeli Türk tıbbi terminolojisi, klinik kılavuzlar ve anonim klinik kayıtlar üzerinde sürekli ön eğitimden (CPT, continued pre-training) geçirdik.
Sürekli ön eğitim, tekrar eden bir döngüdür. Model bir cümlenin başını okur ve sıradaki tokenı tahmin eder; buna ileri geçiş (forward pass) denir. Görseldeki örnekte model, “troponin” kelimesinden sonra en yüksek olasılığı “istendi”ye verir. Tahminin metindeki doğru tokendan ne kadar uzak olduğu, kayıp (loss) adı verilen bir sayıyla ve çapraz entropi (cross-entropy) yöntemiyle ölçülür. Ardından hata modelin katmanlarında geriye doğru izlenir (geri yayılım, backpropagation) ve her parametrenin hataya ne kadar katkı yaptığı hesaplanır (gradyan). Son adımda ağırlıklar, hatayı azaltacak yönde küçük bir adımla güncellenir.
Bu döngü Türkçe klinik metinler üzerinde defalarca tekrarlandıkça model, Türk klinik dilinin terimlerini, kalıplarını ve bağlamını içselleştirir; bu dili ana dili gibi kullanmaya başlar. Eğitim yüksek performanslı GPU altyapısında yapıldı. Hekim ve hastane için sonucu, MINA'nın Türkçe yazılmış bir epikrizi, bir tetkik istemini ya da bir raporu çeviriye ihtiyaç duymadan, klinik bağlamıyla birlikte okumasıdır.

4. LoRA adaptörleri: branş ve görev uzmanlığı
MINA, dört görevde ve 14 klinik branşta ayrı uzmanlık kazandı.
Sürekli ön eğitim modele dili öğretir; belirli bir işi uzman gibi yapmayı ise LoRA adaptörleri kazandırır. LoRA (Low-Rank Adaptation), büyük bir modelin tamamını yeniden eğitmek yerine ona küçük, takılıp çıkarılabilen bir parametre katmanı ekleme yöntemidir. CPT'den sonra temel modelin ağırlıkları dondurulur, yani artık değişmez. Ardından ayrı LoRA adaptörleri eğitilir; bu adaptörler modele branş, kurum ve görev bazında uzmanlık kazandırır. Kuruma özel adaptörler, ilk aşamada anlatıldığı gibi kurumun kendi ortamında eğitilir ve kurumun içinde kalır.
MINA v3.7'de beş ana LoRA adaptörü bulunur: ICD-10 kodlama, epikriz analizi, suistimal ve poliçe değerlendirmesi, SUT uygunluğu ve branş bazlı klinik karar adaptörü. Klinik karar adaptörü 14 branş ve alt branşı kapsar: Genel Cerrahi, Kadın Hastalıkları ve Doğum, Kardiyoloji, Pediatri, Nöroloji, Tıbbi Onkoloji, Ortopedi ve Travmatoloji, Endokrinoloji, Gastroenteroloji, Nefroloji, Hematoloji, Romatoloji, Göğüs Hastalıkları ve Enfeksiyon Hastalıkları. Bu adaptörlere, tek bir göreve değil hepsine hizmet eden üç kesişen yetkinlik katmanı eşlik eder: Türkçe anlama, güvenlik ve halüsinasyon kontrolü, operasyonel optimizasyon.
Çalışma anında bağlama uygun adaptör devreye girer: bir epikriz için ICD-10 kodu önerilirken kodlama uzmanlığı, bir provizyon talebi incelenirken SUT uygunluğu uzmanlığı, bir kardiyoloji vakası değerlendirilirken klinik karar adaptörünün kardiyoloji uzmanlığı öne çıkar. Böylece tek bir model birden çok uzmanlık alanında çalışır ve hesaplama maliyeti düşer. Uzmanlık temel modelin ağırlıklarına değil ayrı adaptörlere yazıldığı için yeni bir branş, kurum ya da görev ihtiyacı temel modele dokunmadan karşılanabilir.

5. GraphRAG: yanıtların kaynağa bağlanması
MINA'nın her yanıtı dayandığı kaynağa kadar izlenebilir.
Bir dil modelinin eğitimde öğrendikleri, eğitimin bittiği anda sabitlenir; tıpta ise kılavuzlar güncellenir, yeni çalışmalar yayımlanır. Bu yüzden MINA yanıt verirken yalnızca eğitimde öğrendiklerine dayanmaz; soruyla ilgili kaynağı bilgi tabanından bulur ve yanıtını ona dayandırır. Bu yaklaşımın adı erişimle desteklenen üretimdir (RAG, retrieval-augmented generation). MINA'da bunu graf tabanlı biçimiyle, yani GraphRAG (graf tabanlı erişimle desteklenen üretim) olarak kurduk.
Biyomedikal literatür bir graf veritabanında indekslenir. Bilgi grafı, tıbbi kavramları ve aralarındaki ilişkileri birbirine bağlı düğümler olarak tutar; böylece bir kavramdan ilişkili kavramlara ve kaynaklara ulaşılır. Tıbbi ders kitapları ise vektör arama altyapısında indekslenir. Vektör arama metinleri kelimelerine göre değil anlamlarına göre eşleştirir; aynı şeyi farklı sözcüklerle anlatan pasajları da bulur. İki kaynak arasındaki yönlendirmeyi, sorunun klinik bağlamına göre bir ML (makine öğrenmesi) yönlendirme katmanı yönetir.
Hekim için bunun karşılığı, MINA'nın her yanıtının dayandığı kaynağa kadar izlenebilmesidir: öneri, dayandığı makale, kılavuz ya da SUT maddesiyle birlikte gelir ve yanıtlar güncel kaynaklara dayanır. Tıbbi literatürdeki gelişmeleri izliyor ve bilgi tabanını güncelliyoruz; bilgi tabanına eklenen yeni bir kılavuz ya da çalışma, yanıtlarda kaynak olarak kullanılabilir.
6. Ajanik orkestrasyon: çok adımlı klinik görevlerin yürütülmesi
MINA, hastanın dijital ikizinde ve kurumun sistemlerinde çok adımlı işleri yürütür; kararı hekime bırakır.
Klinik işler çoğu zaman tek bir sorudan ibaret değildir. Bir provizyon talebini değerlendirmek için hastanın geçmişine bakmak, epikrizi okumak, ilgili SUT maddesini bulmak ve bunları bir araya getirmek gerekir. MINA bu tür çok adımlı görevleri ajanlar aracılığıyla yürütür. Ajan, bir işi tamamlamak için hangi aracın ne zaman kullanılacağını seçen ve adımları sırayla işleten bir yazılım bileşenidir.
Çalışma anında ajanlar hastanın dijital ikizinde ve araçlar arasında dolaşır. Dijital ikiz, hastanın zaman içindeki bütün klinik temaslarının toplandığı tek ve canlı bir profildir; HBYS ve Medula verisi burada birleşir. Ajanlar bu profili okur, bilgi tabanına başvurur ve SUT kurallarını işleten kural motorunu çalıştırır.
Kural değerlendirmesi kural motorunda yapılır; yapay zekâ sonucu gerekçesiyle açıklar. Son kararı ise her zaman kullanıcı verir: hekim, sigorta uzmanı ya da hastane operatörü. Her yanıtta hangi bilginin hasta belgesinden geldiği, hangisinin MINA'nın çıkarımı olduğu ayrı gösterilir ve her çıktı sonradan denetlenebilir.

7. Klinik doğrulama ve sürüm
MINA, 14 branşta ayrı ayrı değerlendirildi; model güncellemeleri hekim kurulunun onayından geçer.
MINA'nın sürümlerini sabit test setleri üzerinde ölçüyor ve birbiriyle karşılaştırıyoruz. Test setleri sentetik ya da anonim vakalardan oluşur ve gerçek hasta verisi içermez; MINA v3.7'yi 14 branşın her birinde ayrı ayrı değerlendirdik. MINA v3.7'nin görev bazlı değerlendirme sonuçlarını MINA v3.7 sayfasında bulabilirsiniz.
Sayısal ölçüm tek başına yetmez; klinik doğruluğu hekimler de denetler. 15 branştan hekimin yer aldığı Hekim Etik ve Danışma Kurulu, modelin klinik doğruluğunu ve etik sınırlarını düzenli olarak denetler, vaka senaryolarını ve model çıktılarını değerlendirir ve model güncellemelerini onaylar.
Onaylanan sürüm kurumun kendi sunucularında ya da izole bir bulut ortamında kurulur; HBYS değişmez, MINA mevcut sistemin üzerinde çalışır. Bu işin arkasında yapay zekâ araştırmacıları, veri mühendisleri, klinik alan uzmanları ile kalite ve regülasyon uzmanlarından oluşan 17 kişilik teknik, operasyon ve iş ortağı ekibimiz var.

Neden bu yolu seçtik
Türk klinik pratiği için bir yapay zekâ modeli kurmanın birden fazla yolu var. Her birini değerlendirdik; aşağıda neden bugünkü mimaride karar kıldığımızı anlatıyoruz.
MINA'nın bilgi tabanını oluşturan
veri kaynakları
MINA'nın bilgi tabanı uluslararası tıbbi literatürden, klinik araştırma kayıtlarından, açık erişimli sağlık veri setlerinden, sigorta ve faturalama kodlamalarından ve kanıta dayalı klinik kılavuzlardan oluşur. MINA hiçbir çıktıyı kaynaksız üretmez; her yanıt bu kaynaklara kadar izlenebilir.
Tıbbi literatür ve yayınlar
- Uluslararası hakemli biyomedikal makale veritabanları
- Açık erişimli akademik literatür dizinleri
- Ön baskı (preprint) arşivleri
- Tıbbi referans ve ders kitabı korpusları
Klinik araştırmalar ve hasta verileri
- Açık klinik araştırma kayıt platformları
- Kamuya açık ulusal sağlık veri setleri
- İzinli ya da lisanslı popülasyon sağlığı kohortları
Elektronik sağlık kayıtları (EHR)
- Açık erişimli, anonimleştirilmiş (de-identifiye) klinik veri setleri
- Anonim yoğun bakım ve hastane araştırma veritabanları
Sigorta ve faturalama veri setleri
- Kamuya açık sağlık ödeme ve faturalama veri setleri
- Üniversite iş birliğiyle lisanslanan uluslararası tıbbi kodlama standartları
Tıbbi rehberler ve kanıta dayalı tıp kılavuzları
- Uluslararası sağlık otoritelerinin yayın depoları
- Kamuya açık düzenleyici ilaç veritabanları
- Hakemli klinik dergiler ve kanıta dayalı tıp kaynakları
Türk sağlık mevzuatı ve standartları
- SGK Sağlık Uygulama Tebliği (SUT)
- Sağlık Bakanlığı Bakanlık Hedefleri (BH-13, BH-32, BH-33, BH-34, BH-35)
- ADSH-13 ve ADSH-14 göstergeleri
- 6698 sayılı Kişisel Verilerin Korunması Kanunu (KVKK)
- TİTCK ilaç ve tıbbi cihaz veritabanı
- e-Nabız ve MKYS entegrasyon standartları
- Resmî Gazete'de yayımlanan sağlık tebliğleri ve yönetmelikleri
- Türk Tabipleri Birliği klinik kılavuzları
- Sağlık Bakanlığı tanı ve tedavi rehberleri
Bütün kaynakları telif ve kullanım haklarına uygun biçimde kullanıyoruz. Lisans gerektiren kaynaklara kurumsal ya da akademik anlaşmalarla erişiyoruz.
Dört platformun
ortak çekirdeği
MINA, Opinion AI'ın dört platformunun ortak çekirdeğidir: TIS hekim, hastane ve laboratuvar için, SIT-I sigorta şirketleri için, SIT-H hastanelerin uyum süreçleri için, SIT-G ise kamu denetimi için çalışır. Dört platformda da aynı klinik bilgi tabanı kullanılır; MINA'nın üstlendiği rol ve yetkiler platforma göre değişir.
Bu platformlarda MINA; hasta dijital ikizi, epikriz analizi ve ICD-10 kodlama, SGK provizyonu ve SUT uygunluğu, eksik belge ve ret riski, laboratuvar sonuçları ve radyoloji raporlarının yorumlanması, suistimal riski taraması ve fatura uyumu gibi işlerde çalışır. Her yetenek ilgili LoRA adaptörünü kullanır, sonucunu GraphRAG ile kaynağa bağlar ve kullanıcının mevcut iş akışının içinde çalışır. Yeteneklerin ayrıntısını hekimler, hastaneler, sigorta şirketleri ve laboratuvarlar için hazırladığımız sayfalarda anlatıyoruz.
Hangi platformda çalışırsa çalışsın kararı her zaman kullanıcı verir; MINA'nın önerisi gerekçesi ve dayandığı kaynakla birlikte gelir. Bu ilkeyi Etik ve Uyum sayfasında ayrıntılı olarak anlatıyoruz.
Kurulum KVKK ve GDPR gerekliliklerine göre, kurumun kendi sunucularında ya da izole bir bulut ortamında yapılır; uyum yaklaşımımızı ve yönetim sistemi sertifikalarımızı Etik ve Uyum ile Bilgi Güvenliği Politikası sayfalarında bulabilirsiniz.
İlgili rehberler ve yazılar
MINA'yı kendi iş akışlarınızda
değerlendirin
Klinik ve idari iş akışlarınızda MINA'yı bir POC çalışmasıyla birlikte değerlendirebiliriz.
POC Talebi